Сентябрь 2026 года отметился рядом значимых событий в области восстановления речи с помощью BCI. Наиболее заметными стали демонстрация персонализированного синтеза речи у полностью парализованного пациента в рамках исследования VOICE компании Neuralink и публикация работы группы Эдварда Чанга (UCSF) об одновременном декодировании речи и жестов с помощью одного импланта. Параллельно были опубликованы работы о новых алгоритмах неинвазивного синтеза речи, а российские исследователи представили результаты по декодированию внутренней речи.
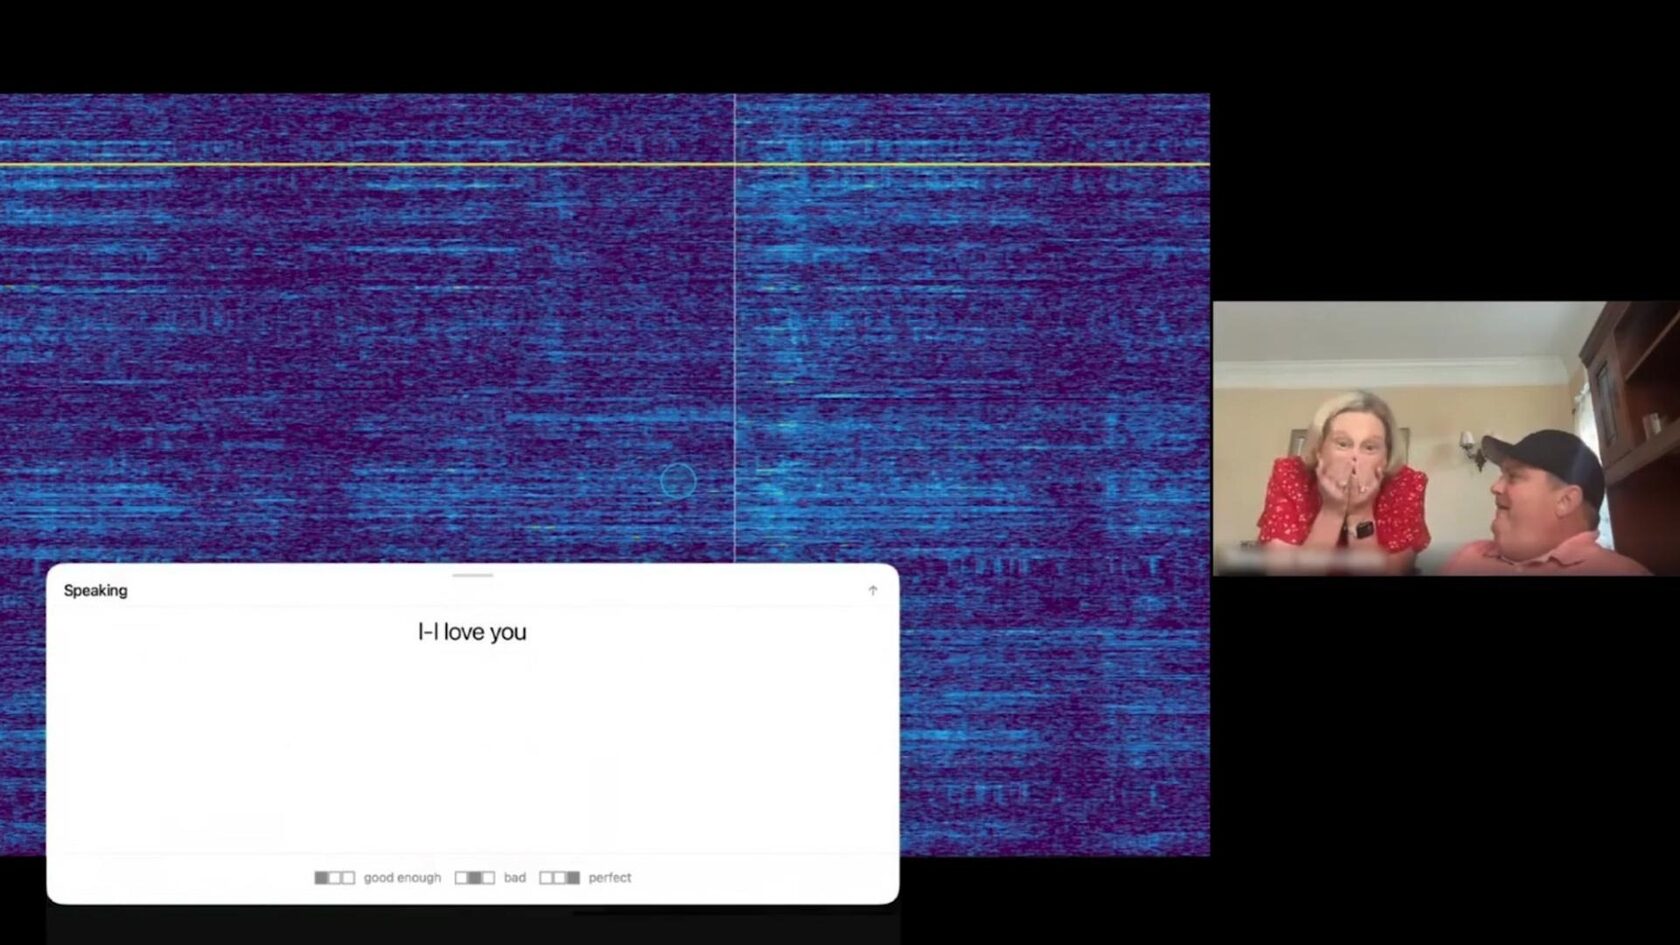
16 сентября 2026 года компания Neuralink опубликовала видеозапись, в которой второй участник исследования VOICE Кеннет Шок (пациент с БАС) произносит фразу «я тебя люблю» без артикуляции и звукового сопровождения. Речь была синтезирована с помощью вживленного в январе 2026 года импланта N1. Технология остаётся экспериментальной: исследование VOICE (NCT07224256) проводится в рамках исследований безопасности и осуществимости и не одобрено FDA для коммерческого применения. Официальные метрики эффективности (скорость речи в минуту, процент ошибок в словах, задержка) Neuralink на данный момент не раскрыла.
16 сентября 2026 года компания Neuralink опубликовала видеозапись, в которой второй участник исследования VOICE Кеннет Шок (пациент с БАС) произносит фразу «я тебя люблю» без артикуляции и звукового сопровождения. Речь была синтезирована с помощью вживленного в январе 2026 года импланта N1. Технология остаётся экспериментальной: исследование VOICE (NCT07224256) проводится в рамках исследований безопасности и осуществимости и не одобрено FDA для коммерческого применения. Официальные метрики эффективности (скорость речи в минуту, процент ошибок в словах, задержка) Neuralink на данный момент не раскрыла.
18 сентября 2026 года Neuralink представила дополнительный релиз с третьим участником исследования VOICE Терри (бульбарная форма БАС). Имплант N1 был размещён в области моторной коры, отвечающей за планирование речи. Система записывает нейронную активность, связанную с намерением говорить; алгоритмы декодируют эти сигналы в фонемы и слова, после чего результат отображается в виде текста и озвучивается через персонализированную модель синтеза речи Grok Voice (от SpaceXAI), обученную на архивных записях голоса Терри, сделанных до болезни. Обучение системы проходило в два этапа: сначала Терри имитировал артикуляцию, затем перешёл к воображаемой речи.
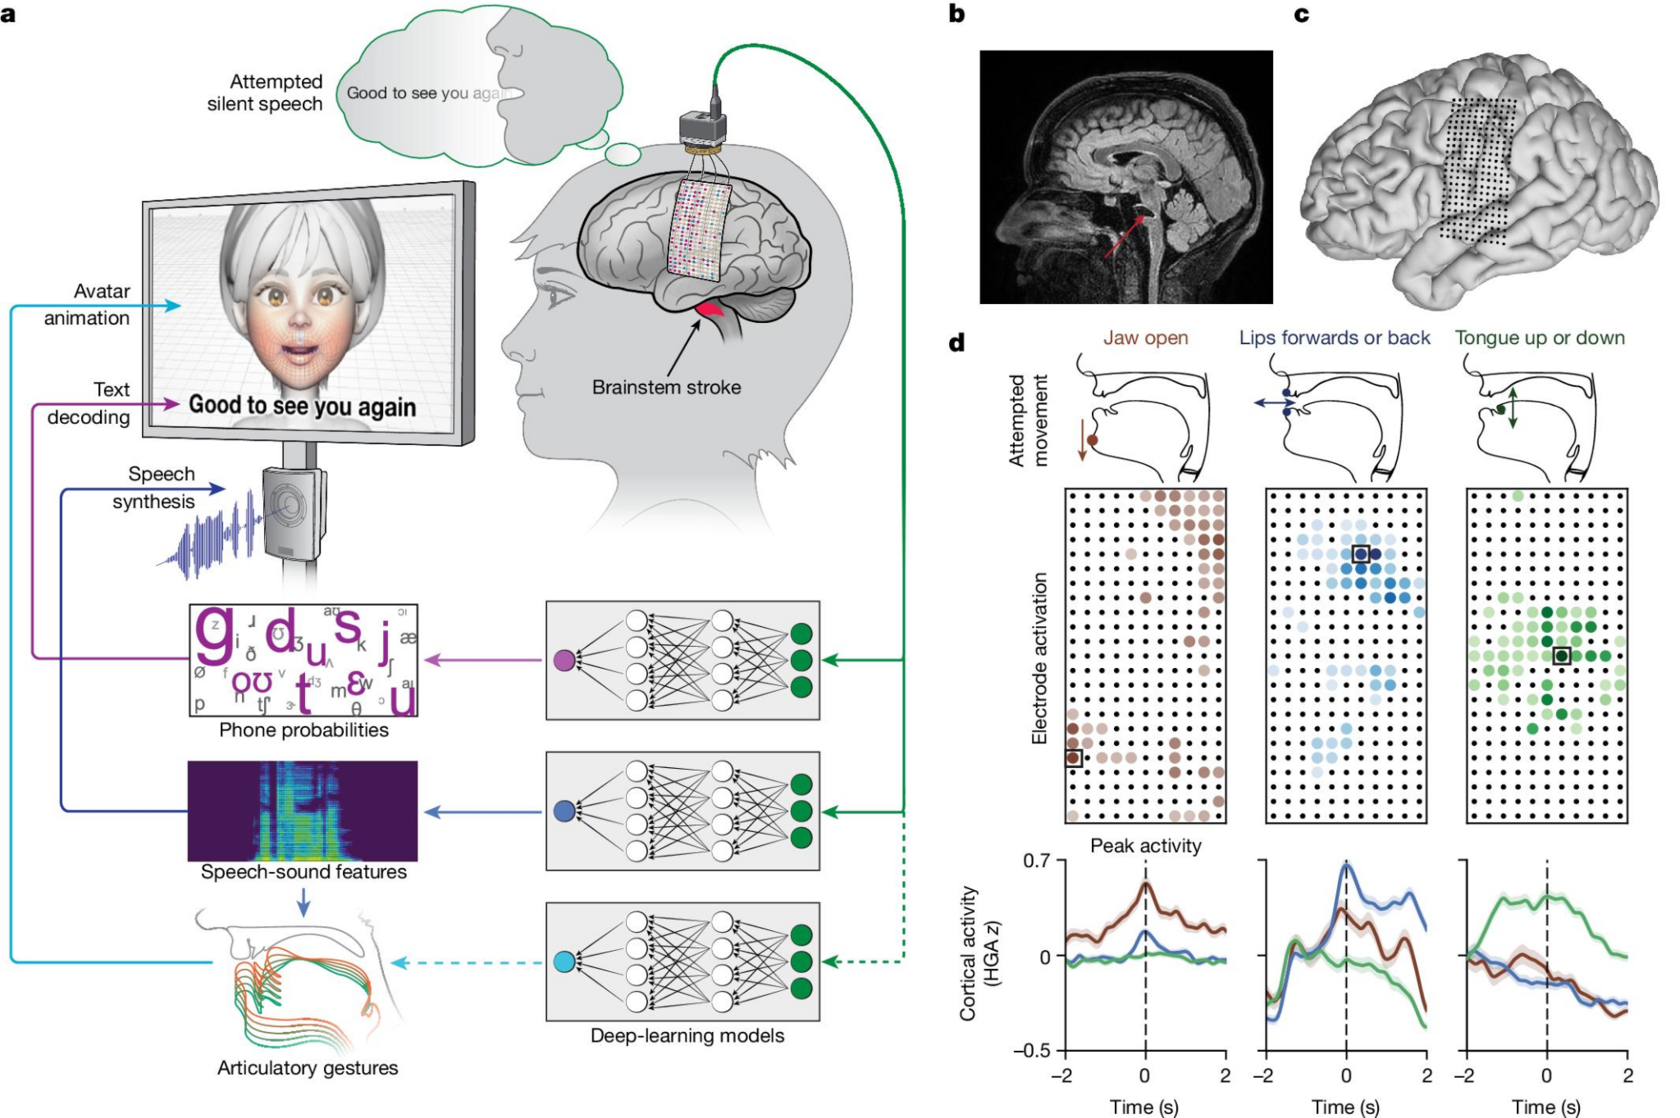
14 сентября 2026 года в журнале Nature Neuroscience вышла статья группы Эдварда Чанга, в которой трём пациентам с параличом (Bravo-1r, Bravo-3 и Bravo-6) был имплантирован высокоплотный массив электродов ECoG (253 канала, PMT Corporation) над сенсомоторной корой. У Bravo-1r и Bravo-3 паралич был вызван инсультом ствола мозга, у Bravo-6 – боковым амиотрофическим склерозом. На начальном этапе все три участника выполнили серию изолированных движений, что позволило подтвердить надёжное декодирование сигналов верхних конечностей и орофациальной мускулатуры. Однако Bravo-3 впоследствии был исключен из протокола, поэтому основные эксперименты по одновременному декодированию речи и жестов, а также управлению аватаром проводились с участием двух пациентов – Bravo-1r и Bravo-6.
Один имплант улавливал сигналы, связанные как с речью, так и с движениями верхних конечностей и лицевой мускулатуры (пожатие плечами, взмах кулаком, кивки). Двое участников управляли персонализированным виртуальным аватаром, выполняя жесты, отвечая на подсказки или делая то и другое одновременно. Bravo-1r достиг медианной точности 100% по речи и жестам в трёх разговорных блоках; Bravo-6 – 85% по жестам и 75% по речи. Совместное обучение на речи и жестах улучшило производительность. Модели, натренированные на изолированных пробах, теряли точность при комбинированных действиях, тогда как смешивание данных решило эту проблему.
За этими результатами стоит ряд методологических вопросов, которые активно обсуждались в профессиональном сообществе. Обзорная статья, посвящённая декодированию воображаемой речи, систематизирует ключевые методологические проблемы, которые затрудняют создание надёжных и обобщаемых систем:
Особое место занимает вопрос о природе декодируемого сигнала: истинно нейронный это сигнал или артефакты от остаточной моторики (движения лица, гортани, головы, вибрации). Важность проблемы демонстрируется и историей рецензирования другого исследования – нейропротеза для мгновенного синтеза голоса у пациента с БАС. Один из рецензентов выразил обеспокоенность тем, что увеличение активности на всех четырёх массивах электродов при акцентуации слов может объясняться артефактами от движений лица и тела. Он отметил, что в видео пациент двигается гораздо больше во время акцентированных слов, и напомнил, что вибрации при беззвучной артикуляции уже использовались для реконструкции речи в том же частотном диапазоне, на который опирается анализ. Авторы провели серию контрольных экспериментов: анализ акустического загрязнения (3% проб с корреляцией на уровне случайности), отдельные декодеры на сигналах стетоскопа и IMU (100% ошибок против 43,6% у нейронного декодера), отслеживание движений головы, отсутствие синтеза при кашле, зевоте или покашливании. После ревизии рецензент заключил, что больше убеждён в нейронной природе сигнала. Хотя замечания касались конкретной работы, они отражают общий методологический стандарт, применимый ко всем интракраниальным BCI, где участники сохраняют остаточную моторику.
В дополнение к интракраниальным системам, вышли работы, расширяющие методологический и прикладной ландшафт речевых нейроинтерфейсов:
Алгоритм SENSE (Semantic-EEG Neural Speech SynthEsis) – метод восстановления речи по неинвазивным сигналам ЭЭГ, учитывающий не только акустику, но и семантику через парадигму N400. На датасете N400 SENSE превзошёл предыдущие решения по акустическим и семантическим метрикам, а в сценарии «невиданный субъект» модель, обученная всего на двух участниках, обошла сильнейший базовый метод, обученный на всех восемнадцати, по word error rate. Работа принята на NeurIPS 2026.
Обзорная статья «От нейронов к диалогу: речевые интерфейсы „мозг – компьютер“ синтезирует исследования в области речевых BCI, рассматривая нейронные субстраты речи, аппаратные методы регистрации (внутрикорковые матрицы, электрокортикографию, стерео-ЭЭГ), архитектуры декодирования (глубокие последовательные модели, языковые априорные модели), адаптацию в замкнутом контуре, оценку, клинический перевод и этику. Авторы подчёркивают, что речевые BCI – это не просто декодеры «нейрон-в-текст», а адаптивные клинические системы, в которых нейронные репрезентации, аппаратное обеспечение, архитектуры декодирования, языковые контексты, обратная связь и обучение пользователя взаимодействуют во времени. Среди приоритетов следующего поколения авторы выделяют оценку систем не только по точности в автономном режиме (офлайн-точности), но и по стабильности работы между сессиями, объёму калибровочной нагрузки, задержке сигнала, уровню неопределённости, удобству использования и наличию защитных механизмов от непреднамеренного декодирования мыслительных процессов.
Brain2Speech-Net представляет собой одноэтапную архитектуру синтеза речи напрямую из нейронной активности без промежуточного текстового декодирования. Метод использует дифференцируемое фонемное «узкое горлышко» (bottleneck) и механизм выравнивания на основе глубоких скрытых марковских моделей (deep-HMM) для отображения длинных нейронных записей в латентное пространство модели синтеза речи (TTS). Это позволяет достичь высокого качества и разборчивости генерируемой речи со скоростью, превышающей реальное время. Данная работа демонстрирует альтернативный подход к снижению задержки сигнала и упрощению технологического контура по сравнению с многоэтапными каскадными системами последовательного перевода активности мозга в текст, а затем в речь.
Российские исследовательские группы занимают заметные позиции в области декодирования внутренней речи (мысленного воспроизведения слов без артикуляции и звука). Исследователи из Центра нейротехнологий Южного федерального университета (ЮФУ) опубликовали в журнале Scientific Data первый в своем роде открытый стандартизированный датасет ЭЭГ-паттернов внутренней речи. База содержит 38-канальные записи активности мозга 22 здоровых добровольцев (12 носителей русского языка, 10 носителей испанского), выполнявших мысленное и устное произнесение шести пространственно-навигационных команд: «вверх», «вниз», «влево», «вправо», «вперёд» и «назад». Базовая проверка качества данных с помощью стандартных методов машинного обучения показала точность распознавания состояний на уровне 78 ± 4%, что подтверждает наличие в сигналах четких, специфических для каждой команды нейронных маркеров. Опубликованные материалы призваны стать международным стандартом для обучения и тестирования новых алгоритмов распознавания речи в неинвазивных BCI.
Параллельно в совместном исследовании Института проблем передачи информации им. А.А. Харкевича РАН, Сколтеха и Федерального центра нейрохирургии (Тюмень) на 11 пациентах с эпилепсией были изучены тонкие механизмы мысленного кодирования. С помощью метода стерео-ЭЭГ авторы зафиксировали, что речевые процессы вызывают специфические модуляции в альфа- (8–12 Гц) и гамма- (50–80 Гц) диапазонах в лобных и височных долях. Эксперимент показал, что внутренняя речь нейронально представляет собой наиболее изолированное, самостоятельное состояние: она отличается от открытой и беззвучно артикулируемой речи сниженной и отсроченной активацией моторных и языковых зон, а в ряде областей модуляция ритмов и вовсе нивелируется. Чтобы исключить артефакты общего когнитивного напряжения, в протокол было введено контрольное задание – письмо от руки, продемонстрировавшее принципиально иную динамику спектров. В результате обученный классификатор достиг средней точности в 72% при различении трёх речевых условий на основе их спектральных профилей. Работа доказывает, что sEEG-интерфейсы способны надежно улавливать переходы между скрытыми и явными формами языка, что критически важно для создания мультимодальных речевых нейропротезов.
Сентябрь 2026 года ознаменовал переход речевых нейроинтерфейсов от демонстраций к системной оценке эффективности. Интракраниальные системы достигли разборчивого синтеза речи в реальном времени и многомодального декодирования, однако ключевым вопросами остаются природа декодируемого сигнала и устойчивость систем между сессиями. Параллельно неинвазивные подходы и декодирование внутренней речи формируют отдельное направление, где российские группы демонстрируют заметные результаты. Общий вектор – смещение фокуса с точности в автономном режиме на робастность, калибровочную нагрузку, задержку и защиту от непреднамеренного декодирования.
- Отсутствие чёткого поведенческого выхода – при внутренней речи нет наблюдаемого акустического сигнала для прямого сопоставления с нейронной активностью.
- Слабые и вариативные нейронные сигнатуры – низкая амплитуда, высокий уровень шума, значительная межиндивидуальная вариабельность.
- Отсутствие стабильного временного выравнивания – нет явных временных меток (онсет фонем, слов), что затрудняет синхронизацию данных.
- Нестационарность сигнала – нейронные сигналы меняются со временем из-за адаптации коры, миграции электродов, тканевых реакций.
- Ограниченная кросс-субъектная генерализация – декодеры плохо обобщаются на других участников без индивидуальной калибровки.
Особое место занимает вопрос о природе декодируемого сигнала: истинно нейронный это сигнал или артефакты от остаточной моторики (движения лица, гортани, головы, вибрации). Важность проблемы демонстрируется и историей рецензирования другого исследования – нейропротеза для мгновенного синтеза голоса у пациента с БАС. Один из рецензентов выразил обеспокоенность тем, что увеличение активности на всех четырёх массивах электродов при акцентуации слов может объясняться артефактами от движений лица и тела. Он отметил, что в видео пациент двигается гораздо больше во время акцентированных слов, и напомнил, что вибрации при беззвучной артикуляции уже использовались для реконструкции речи в том же частотном диапазоне, на который опирается анализ. Авторы провели серию контрольных экспериментов: анализ акустического загрязнения (3% проб с корреляцией на уровне случайности), отдельные декодеры на сигналах стетоскопа и IMU (100% ошибок против 43,6% у нейронного декодера), отслеживание движений головы, отсутствие синтеза при кашле, зевоте или покашливании. После ревизии рецензент заключил, что больше убеждён в нейронной природе сигнала. Хотя замечания касались конкретной работы, они отражают общий методологический стандарт, применимый ко всем интракраниальным BCI, где участники сохраняют остаточную моторику.
В дополнение к интракраниальным системам, вышли работы, расширяющие методологический и прикладной ландшафт речевых нейроинтерфейсов:
Алгоритм SENSE (Semantic-EEG Neural Speech SynthEsis) – метод восстановления речи по неинвазивным сигналам ЭЭГ, учитывающий не только акустику, но и семантику через парадигму N400. На датасете N400 SENSE превзошёл предыдущие решения по акустическим и семантическим метрикам, а в сценарии «невиданный субъект» модель, обученная всего на двух участниках, обошла сильнейший базовый метод, обученный на всех восемнадцати, по word error rate. Работа принята на NeurIPS 2026.
Обзорная статья «От нейронов к диалогу: речевые интерфейсы „мозг – компьютер“ синтезирует исследования в области речевых BCI, рассматривая нейронные субстраты речи, аппаратные методы регистрации (внутрикорковые матрицы, электрокортикографию, стерео-ЭЭГ), архитектуры декодирования (глубокие последовательные модели, языковые априорные модели), адаптацию в замкнутом контуре, оценку, клинический перевод и этику. Авторы подчёркивают, что речевые BCI – это не просто декодеры «нейрон-в-текст», а адаптивные клинические системы, в которых нейронные репрезентации, аппаратное обеспечение, архитектуры декодирования, языковые контексты, обратная связь и обучение пользователя взаимодействуют во времени. Среди приоритетов следующего поколения авторы выделяют оценку систем не только по точности в автономном режиме (офлайн-точности), но и по стабильности работы между сессиями, объёму калибровочной нагрузки, задержке сигнала, уровню неопределённости, удобству использования и наличию защитных механизмов от непреднамеренного декодирования мыслительных процессов.
Brain2Speech-Net представляет собой одноэтапную архитектуру синтеза речи напрямую из нейронной активности без промежуточного текстового декодирования. Метод использует дифференцируемое фонемное «узкое горлышко» (bottleneck) и механизм выравнивания на основе глубоких скрытых марковских моделей (deep-HMM) для отображения длинных нейронных записей в латентное пространство модели синтеза речи (TTS). Это позволяет достичь высокого качества и разборчивости генерируемой речи со скоростью, превышающей реальное время. Данная работа демонстрирует альтернативный подход к снижению задержки сигнала и упрощению технологического контура по сравнению с многоэтапными каскадными системами последовательного перевода активности мозга в текст, а затем в речь.
Российские исследовательские группы занимают заметные позиции в области декодирования внутренней речи (мысленного воспроизведения слов без артикуляции и звука). Исследователи из Центра нейротехнологий Южного федерального университета (ЮФУ) опубликовали в журнале Scientific Data первый в своем роде открытый стандартизированный датасет ЭЭГ-паттернов внутренней речи. База содержит 38-канальные записи активности мозга 22 здоровых добровольцев (12 носителей русского языка, 10 носителей испанского), выполнявших мысленное и устное произнесение шести пространственно-навигационных команд: «вверх», «вниз», «влево», «вправо», «вперёд» и «назад». Базовая проверка качества данных с помощью стандартных методов машинного обучения показала точность распознавания состояний на уровне 78 ± 4%, что подтверждает наличие в сигналах четких, специфических для каждой команды нейронных маркеров. Опубликованные материалы призваны стать международным стандартом для обучения и тестирования новых алгоритмов распознавания речи в неинвазивных BCI.
Параллельно в совместном исследовании Института проблем передачи информации им. А.А. Харкевича РАН, Сколтеха и Федерального центра нейрохирургии (Тюмень) на 11 пациентах с эпилепсией были изучены тонкие механизмы мысленного кодирования. С помощью метода стерео-ЭЭГ авторы зафиксировали, что речевые процессы вызывают специфические модуляции в альфа- (8–12 Гц) и гамма- (50–80 Гц) диапазонах в лобных и височных долях. Эксперимент показал, что внутренняя речь нейронально представляет собой наиболее изолированное, самостоятельное состояние: она отличается от открытой и беззвучно артикулируемой речи сниженной и отсроченной активацией моторных и языковых зон, а в ряде областей модуляция ритмов и вовсе нивелируется. Чтобы исключить артефакты общего когнитивного напряжения, в протокол было введено контрольное задание – письмо от руки, продемонстрировавшее принципиально иную динамику спектров. В результате обученный классификатор достиг средней точности в 72% при различении трёх речевых условий на основе их спектральных профилей. Работа доказывает, что sEEG-интерфейсы способны надежно улавливать переходы между скрытыми и явными формами языка, что критически важно для создания мультимодальных речевых нейропротезов.
Сентябрь 2026 года ознаменовал переход речевых нейроинтерфейсов от демонстраций к системной оценке эффективности. Интракраниальные системы достигли разборчивого синтеза речи в реальном времени и многомодального декодирования, однако ключевым вопросами остаются природа декодируемого сигнала и устойчивость систем между сессиями. Параллельно неинвазивные подходы и декодирование внутренней речи формируют отдельное направление, где российские группы демонстрируют заметные результаты. Общий вектор – смещение фокуса с точности в автономном режиме на робастность, калибровочную нагрузку, задержку и защиту от непреднамеренного декодирования.
Список использованной литературы:
- Brosler, S.C., Liu, J.R., Silva, A.B. et al. Simultaneous speech and gesture decoding for multimodal communication in paralysis. Nat Neurosci (2026). https://doi.org/10.1038/s41593-026-02446-2
- Chandra, S. S., Cai, Z., Tsao, Y., King, S., & Sisman, B. (2026). Brain2Speech-Net: Fast and Intelligible Brain-to-Speech Synthesis Without Text Decoding (arXiv Preprint arXiv:2609.04455). https://arxiv.org/abs/2609.04455
- Khajehnejad, M., Habibollahi, F., Boccato, T., Sousa, M., Olak, M., Sheiban, F. J., & Ferrante, M. (2026). From Neurons to Conversation: Speech Brain-Computer Interfaces (arXiv Preprint arXiv:2609.36736). https://arxiv.org/abs/2609.36736
- Kostulin, D. V., Shaposhnikov, P. D., Ekizyan, A. K., Shevchenko, I. G., Shaposhnikov, D. G., Shcherban, I. V., & Kiroy, V. N. (2026). EEG-based brain-computer interface (BCI) dataset for directional word recognition. Scientific Data, 13(1), 1195.
- Naumov, A.V., Soghoyan, G.A., Makarova, A.V. et al. A stereoencephalography study of internal speech. Cogn Neurodyn 20, 183 (2026). https://doi.org/10.1007/s11571-026-10554-9
- Park, J., Lee, S., Park, H., & Kwon, J. (2026). SENSE: Semantic Neural Speech Synthesis from Brain Dynamics via Spatial Graph Encoding
- (arXiv Preprint arXiv:2609.37601). https://arxiv.org/abs/2609.37601
- Wairagkar, M., Card, N. S., Singer-Clark, T., Hou, X., Iacobacci, C., Miller, L. M., ... & Stavisky, S. D. (2025). An instantaneous voice-synthesis neuroprosthesis. Nature, 644(8075), 145-152.
- Zhang, H., Siok, W. T., & Wang, N. (2026). Imagined Speech Brain–Computer Interface: A Task-Oriented Review of Neural Decoding. Sensors, 26(10), 3212